
Nhưng sở hữu dữ liệu đó chưa chắc đã giúp bạn giành được citation, vì cấu trúc trình bày và việc có nằm trong tập nguồn được AI tin tưởng hay không mới là yếu tố quyết định ai thực sự thắng cuộc.
Tóm tắt các điểm chính:
Dữ liệu gốc là yếu tố dự đoán mạnh nhất cho tính nguyên bản của một trang, mạnh hơn cả độ dài nội dung.
Là người đầu tiên công bố một con số không đảm bảo bạn sẽ là người được trích dẫn cho con số đó. Một aggregator trình bày lại số liệu của bạn theo cách gọn gàng, dễ trích xuất hơn hoàn toàn có thể "cướp" mất citation mà nghiên cứu của bạn xứng đáng có được.
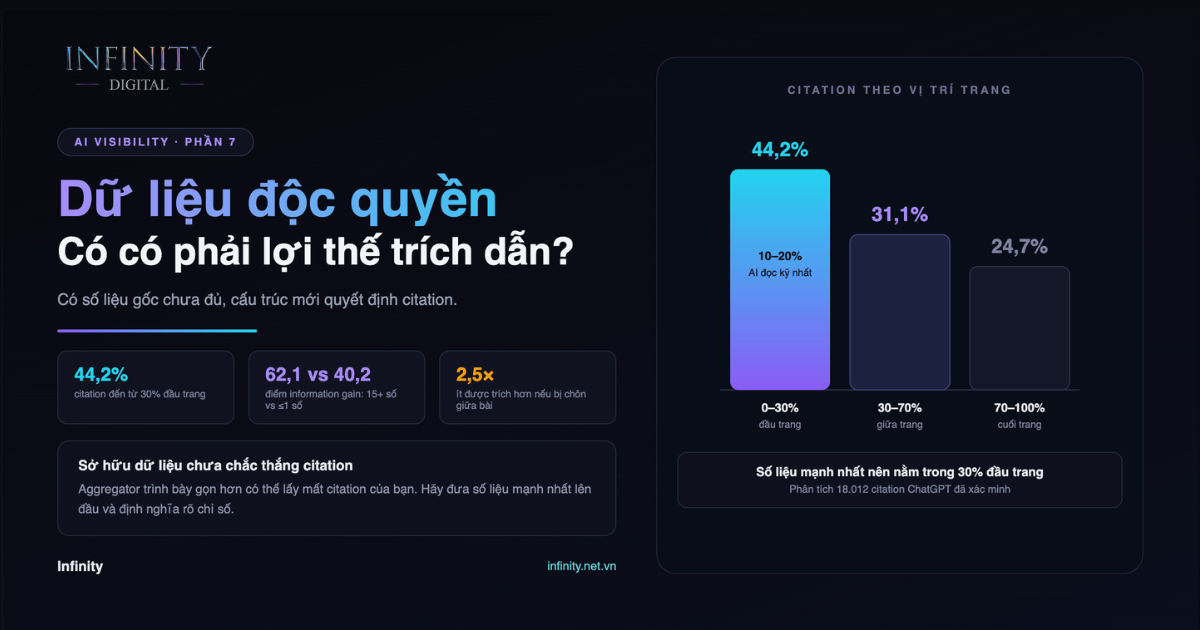
Phân tích 18.012 citation ChatGPT đã xác minh cho thấy một mô hình phân phối dốc trượt: 44,2% tổng citation đến từ 30% đầu trang.
Loại thực thể dự đoán citation ChatGPT mạnh nhất là NGÀY THÁNG và SỐ LIỆU, và nội dung được trích dẫn nhiều thường dày đặc thực thể cụ thể: một phương pháp luận cụ thể, một số liệu chính xác, một phép so sánh có tên tuổi rõ ràng.
Bên thắng cuộc là thương hiệu vừa sở hữu dữ liệu sản phẩm, dữ liệu sử dụng hay dữ liệu giá độc quyền, vừa biết cấu trúc nó để dễ trích xuất, và không bỏ qua các đòn bẩy authority khác ngoài dữ liệu.
Xuất bản số liệu gốc từ chính sản phẩm của bạn, không phải dữ liệu được xào nấu chỉ để tạo ra thêm nội dung mới chính là đòn bẩy đơn lẻ đáng tin cậy nhất để làm cho một trang trở nên nguyên bản.
Cách làm cũ là trả tiền cho một công ty PR hay nghiên cứu để làm một khảo sát có liên hệ lỏng lẻo với sản phẩm. Cách đó đã lỗi thời. Gần như mọi sản phẩm ngày nay đều tự sinh ra dữ liệu đáng để công bố, và việc khai thác nó chưa bao giờ dễ dàng đến vậy. Bạn không cần một đội nghiên cứu. Ngưỡng để vượt qua phần lớn thị trường thấp hơn nhiều so với bạn nghĩ.
1/ Dữ liệu gốc có thực sự là yếu tố dự đoán mạnh nhất cho tính nguyên bản không?
Có, và mạnh hơn bất kỳ đặc điểm cấp trang nào khác, kể cả độ dài nội dung, theo một nghiên cứu gần đây của On-Page.ai. [1]
Nghiên cứu này chấm điểm 150 trang đang xếp top 3 Google trên 50 từ khóa thuộc 10 ngành, dựa trên mức độ mỗi trang đóng góp thêm điều gì đó vượt ra ngoài phần còn lại của nhóm trang cùng xếp hạng, chấm theo ý nghĩa thay vì câu chữ, trên thang điểm 0 đến 100. Trang trung vị đạt 52 điểm, và dữ liệu gốc có tương quan với điểm số này mạnh hơn bất kỳ đặc điểm nào khác. Trang có tối đa 1 con số độc đáo đạt trung bình 40,2 điểm information gain, trong khi trang có từ 15 con số trở lên đạt trung bình 62,1 điểm, và điểm số này tăng đều đặn qua từng nấc ở giữa.
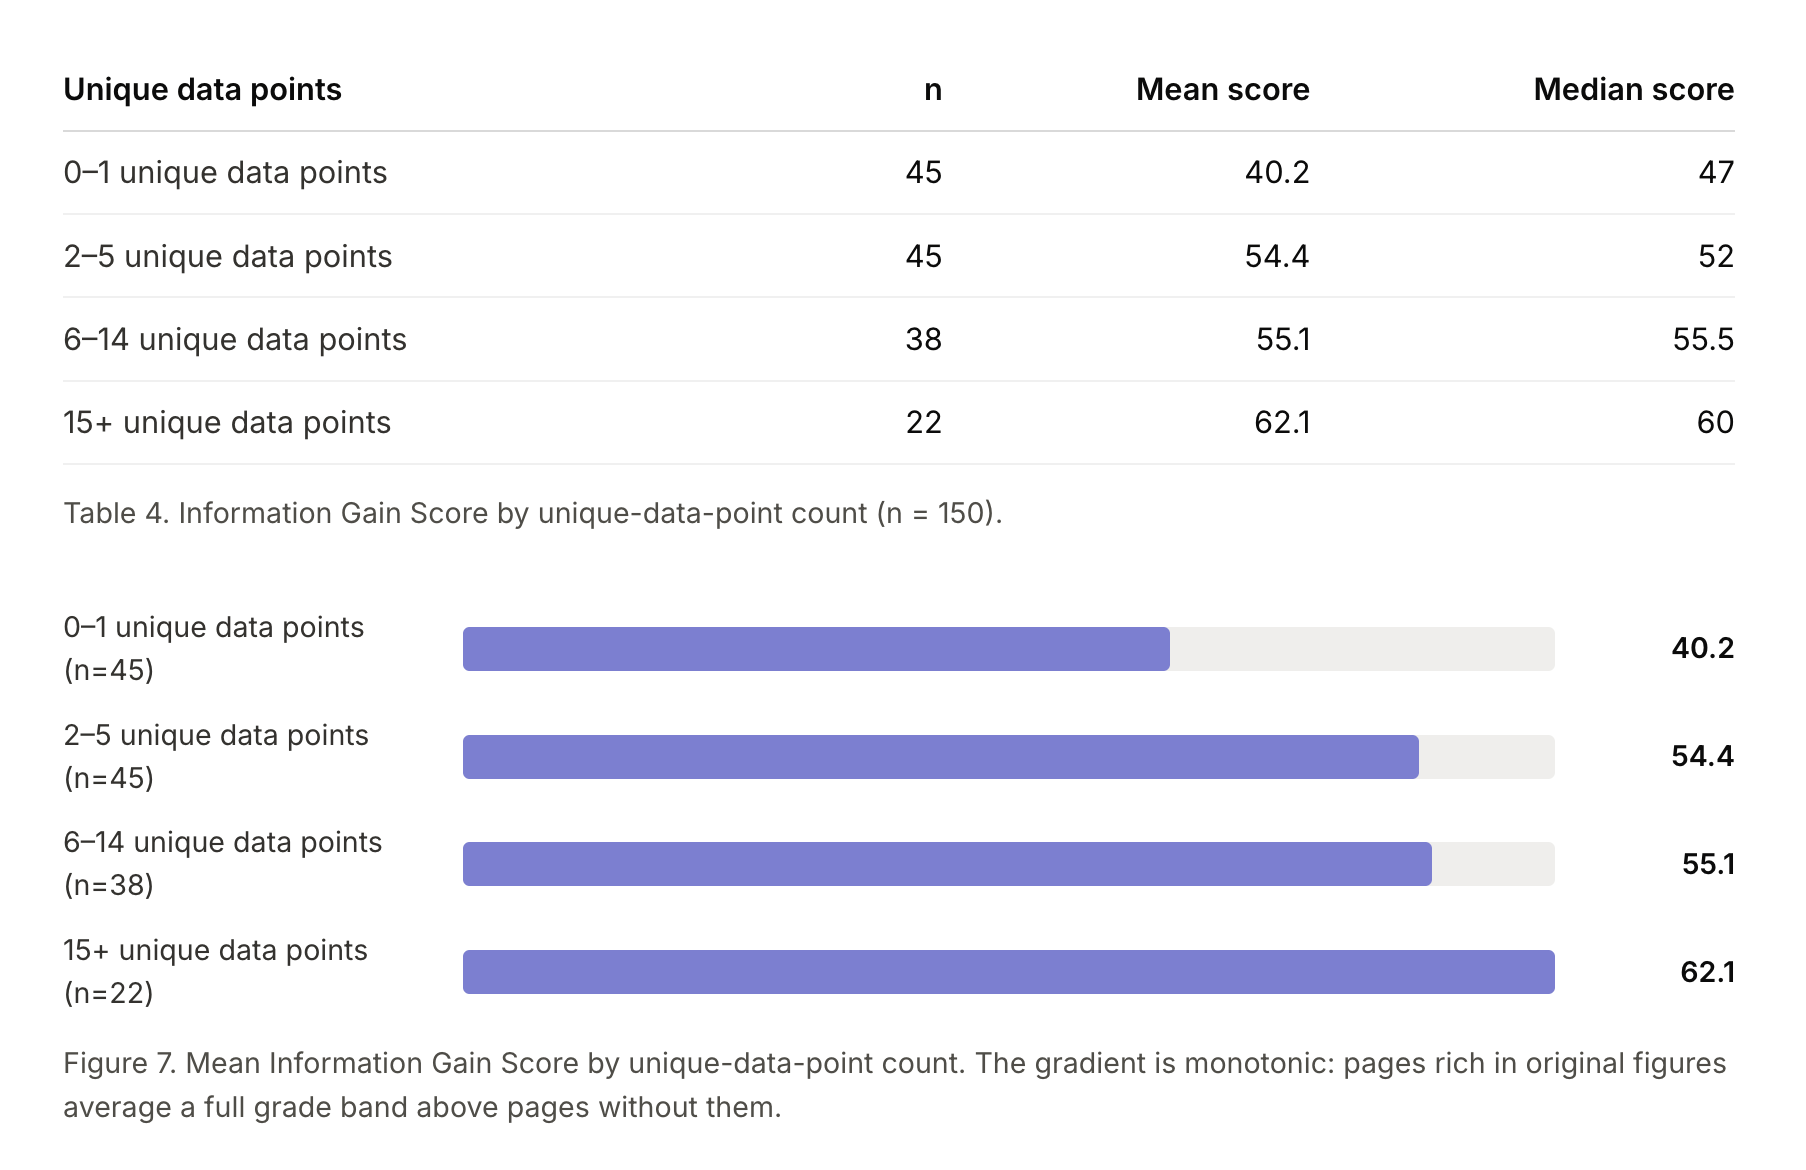
Nguồn: on-page.ai
Tin tốt là ngưỡng cần vượt qua khá thấp. Nghiên cứu cho thấy không cần quá nhiều bằng chứng gốc để vượt mặt các trang đang xếp hạng tốt trên Google thông thường: kết quả hữu cơ top đầu trung bình chỉ có 4 điểm dữ liệu độc đáo. Xuất bản một trang chứa hơn 4 tuyên bố, con số, hay câu trả lời gốc thực sự, và bạn đã có thêm một đòn bẩy cho khả năng hiển thị hữu cơ vốn đang ngày càng cạnh tranh.
Phân tích này cũng phát hiện rằng trong gần như mọi lượt tìm kiếm, luôn có rất nhiều câu hỏi liên quan chưa được trả lời đang bị bỏ ngỏ. On-Page.ai chạy phân tích với các câu hỏi độc giả tổng hợp (synthetic reader questions), một tập câu hỏi hợp lý được tạo ra cho nghiên cứu, có liên hệ chặt với chủ đề tìm kiếm của từng truy vấn, và kết quả cho thấy một cánh cửa mở cho những trang mới trả lời đúng các câu hỏi đó để nổi bật. Nghe quen không? Đây chính là bản chất của query fan-out.
Chúng tôi từng có một phát hiện tương tự trong một phân tích về citation ChatGPT:
Một trang evergreen duy nhất bao phủ hơn 10 query intent có giá trị hơn hẳn 10 trang chỉ giải quyết một intent riêng lẻ, xét theo phạm vi citation AI. ROI của nội dung toàn diện dồn về phía trước: một trang được xây tốt sẽ cộng dồn phạm vi citation theo thời gian. Đuôi dài vẫn tồn tại, nhưng top 5% trang tốt nhất chiếm một tỷ trọng bất cân xứng trong toàn bộ hoạt động citation đang diễn ra.
Vì lý do đó, các prompt có intent cao của thương hiệu nên được theo dõi xuyên suốt cả hành trình mua hàng, thay vì chỉ nhìn từng prompt riêng lẻ. Hãy biến chúng thành một hành trình đi theo năm giai đoạn của người mua: Vấn đề, Khám phá, So sánh, Xác thực, và Lựa chọn. Trả lời đúng những câu hỏi đó ngay trên trang, bằng chính kiến thức và chuyên môn mà chỉ thương hiệu của bạn mới có, để giữ vững lợi thế cạnh tranh trước phát hiện này.
Kết luận chính từ toàn bộ nghiên cứu: phần lớn trang chỉ ở mức tầm tầm về tính nguyên bản, trang thực sự nguyên bản là thiểu số, và đạt đủ điểm để nổi bật là điều hoàn toàn khả thi, không đòi hỏi một nỗ lực phi thường nào. Điểm thiếu sót của nghiên cứu này là nó chỉ nhìn vào khả năng hiển thị và xếp hạng tìm kiếm cổ điển (khái niệm information gain trong SEO vốn dĩ bắt nguồn từ ngôn ngữ trong một bằng sáng chế của Google), chưa hề tính đến citation hay mention của AI, và cũng không đề cập đến việc đưa AI Mode hay AI Overviews vào phân tích.
2/ Sở hữu dữ liệu gốc có đảm bảo bạn giành được citation không?
Không, và đây chính là phần mà phần lớn lời khuyên về xuất bản dữ liệu độc quyền thường bỏ qua.
Lưu ý: Chỉ riêng việc là nguồn chính thôi chưa chắc đã đủ để được trích dẫn.
Ai cũng nói hãy xuất bản nghiên cứu gốc. Rất ít người thực sự kiểm chứng xem AI thưởng cho thương hiệu đã tạo ra con số đó, hay thưởng cho trang trình bày con số đó dễ đọc nhất.
Còn nhiều phân tích khác sẽ được công bố trong thời gian tới, nhưng đây là những gì Infinity đã đúc kết được qua năm vừa rồi:
Loại thực thể dự đoán citation ChatGPT mạnh nhất là NGÀY THÁNG và SỐ LIỆU. Trang được trích dẫn nhiều thường dày đặc các thực thể cụ thể:
một phương pháp luận riêng,
một số liệu thống kê chính xác,
một phép so sánh có tên tuổi rõ ràng.
Ngay cả khi phát hiện độc quyền của bạn bị một nguồn khác tổng hợp lại và nguồn đó được trích dẫn thay vì bạn, những tín hiệu authority từ bên thứ ba đó vẫn có khả năng được xây dựng dần lên theo thời gian.
Mật độ thực thể và sentiment cân bằng cũng quan trọng. Lời khuyên chung chung vừa rủi ro vừa mơ hồ, còn thực thể cụ thể thì có căn cứ và có thể kiểm chứng. Dữ liệu độc quyền tạo ra, xác minh, hoặc củng cố nội dung dày đặc thực thể, chẳng hạn lý do vì sao một tính năng giúp tiết kiệm bao nhiêu phần trăm chi phí, hay khách hàng tiết kiệm được bao nhiêu giờ so với khi dùng đối thủ trước đó. Thêm sentiment cân bằng vào phần phân tích và giải thích dữ liệu, và bạn đã có một chiến thuật "một công đôi việc".
Nếu giả thuyết rằng dữ liệu first-party là yếu tố sống còn trong kỷ nguyên AI search là đúng, thì việc xuất bản nội dung dựa trên dữ liệu độc quyền là điều cần thiết, nhưng chưa đủ. Cấu trúc trích xuất của LLM, cùng với việc trang có nằm trong tập nguồn mà công cụ AI search tin tưởng cho chủ đề đó hay không, mới là yếu tố quyết định ai giành được citation, ngay cả khi chính bạn là người sở hữu dữ liệu gốc. Thật đáng tiếc, một aggregator (bên thứ ba tổng hợp nội dung) trình bày lại benchmark của bạn thành một trang gọn gàng, sẵn sàng để AI trích xuất, hoàn toàn có thể thu về đúng citation mà nghiên cứu của bạn đã xứng đáng có được.
Bên thắng cuộc là những thương hiệu đang ngồi trên dữ liệu sản phẩm, dữ liệu sử dụng, hay dữ liệu giá độc quyền, đồng thời biết cấu trúc nó để dễ trích xuất và không bỏ qua các đòn bẩy xây dựng authority thương hiệu khác. (Tìm hiểu thêm trong Cách xây dựng chiến lược AI SEO bền vững của chúng tôi)
Bên thua cuộc là những thương hiệu chỉ sản xuất nội dung quan điểm mà bất kỳ công cụ nào cũng có thể sao chép được, bỏ qua các cách quan trọng khác để xây dựng authority off-site, cùng với chính những nguồn gốc dữ liệu lại chôn vùi con số của mình trong lối kể chuyện dài dòng thay vì đưa nó lên bề mặt. (Đọc nội dung này "Người thắng và kẻ thua trong AI Search" để biết thương hiệu thắng trong cuộc chơi này làm những gì?)
Liệu có ngành nào thưởng cho nội dung dữ liệu nhiều hơn ngành khác hay không, chúng tôi chưa có câu trả lời. Loạt phân tích trước đây của chúng tôi từng phát hiện tín hiệu citation biến động rất mạnh theo từng ngành, nên nếu có một mức thưởng đồng đều cho mọi ngành thì đó mới là điều đáng ngạc nhiên, nhưng tôi sẽ không khẳng định một mô hình nào khi chưa có đủ dữ liệu.
3/ Nên cấu trúc dữ liệu như thế nào để AI dễ trích xuất?
Sở hữu dữ liệu giúp bạn có mặt trong cuộc đua giành khả năng hiển thị, nhưng cách bạn cấu trúc nội dung mới có thể là yếu tố quyết định bạn có thắng cuộc đua đó hay không.
Từ nội dung “AI Citation trong phần 2”, Infinity đã phân tích 18.012 citation ChatGPT đã được xác minh và phát hiện ra một mô hình phân phối dạng "dốc trượt": 44,2% tổng citation đến từ 30% đầu trang. Phần giữa của trang, từ 30 đến 70%, chỉ chiếm 31,1%. Nội dung bị chôn sâu trong một bài viết dài có khả năng được trích dẫn thấp hơn khoảng 2,5 lần.
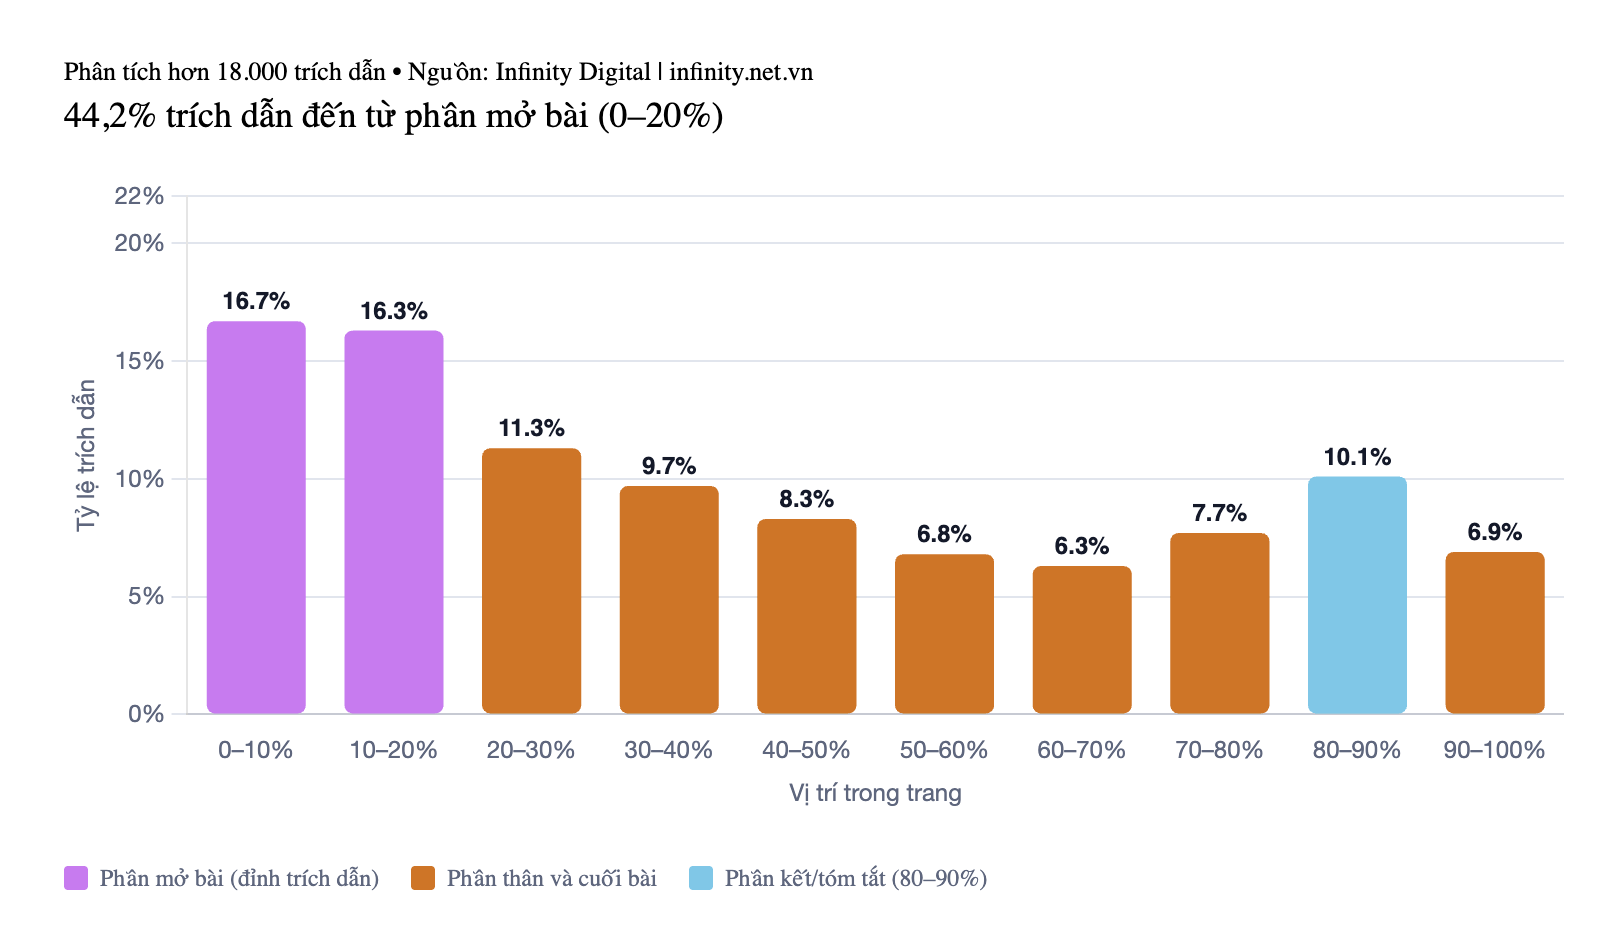
Phân tích tiếp theo ở phần 4 trên 7 ngành đã làm rõ hơn mục tiêu cần nhắm tới: dải 10-20% của trang là nơi AI đọc kỹ nhất ở mọi ngành, trong khi 10% đầu tiên thường chỉ là phần điều hướng và mở bài mang tính đệm mà AI thường bỏ qua.

10% cuối cùng của bất kỳ trang nào cũng chỉ nhận được từ 2,4% đến 4,4% citation, bất kể thuộc ngành nào.
Áp dụng vào một bài viết dạng nghiên cứu dữ liệu, cấu trúc gần như tự nó hiện ra rõ ràng:
1/ Mở đầu bằng số liệu tiêu đề. Con số mạnh nhất của bạn cần nằm trong 30% đầu trang, lý tưởng nhất là ngay sau khối tiêu đề, nơi dải 10-20% bắt đầu. Theo trình tự: con số, rồi so sánh, rồi ý nghĩa, tất cả trong màn hình đầu tiên.
2/ Định nghĩa chỉ số ngay lập tức. Một câu duy nhất giải thích con số đó đo lường điều gì và áp dụng cho nhóm đối tượng nào. Một số liệu không được định nghĩa rõ sẽ khó được trích dẫn với sự tự tin.
3/ Đóng khung phương pháp luận. Cỡ mẫu, khung thời gian, cách thu thập dữ liệu, gói gọn trong một khối ngắn được dán nhãn rõ ràng. Độ tin cậy về nguồn gốc chính là một phần khiến một con số trở nên đáng được trích dẫn.
4/ Đưa mọi phát hiện phụ lên trước. Xếp các phát hiện theo mức độ mạnh yếu, mạnh nhất đứng đầu. Kiểu xây dựng câu chuyện dài 20 đoạn văn trước khi vào ý chính là mô hình giữ chân người đọc, nhưng lại làm mất đi citation từ máy.
5/ Bỏ qua kiểu kết bài giữ bí mật đến cuối. AI đọc giống một biên tập viên bận rộn, không phải một học sinh kiên nhẫn. Cấu trúc "nội dung quan trọng nằm ở cuối bài" từng hiệu quả với các "ultimate guide" giờ đây lại đang phản tác dụng với việc trích xuất.
Trang nào đang được tin tưởng cho đúng chủ đề của thương hiệu bạn? Khi một aggregator thu về citation mà nghiên cứu của bạn xứng đáng có được, đó là vì họ đã có mặt sẵn trong tập nguồn được AI tin tưởng cho chủ đề đó, còn bạn thì chưa.
Đây là câu hỏi đáng để bất kỳ đội content nào cũng nên tự đặt ra và trả lời bằng dữ liệu thực tế của chính mình, trước khi đổ công sức xuất bản thêm một nghiên cứu gốc khác.
Kết luận
Xuất bản dữ liệu gốc vẫn là đòn bẩy mạnh nhất để làm cho nội dung trở nên nguyên bản, và ngưỡng để làm tốt hơn phần lớn thị trường thấp hơn nhiều so với tưởng tượng, chỉ cần hơn 4 điểm dữ liệu độc đáo trên một trang. Nhưng làm ra dữ liệu gốc mới chỉ là điều kiện cần. Nếu cấu trúc trang không đưa số liệu mạnh nhất lên 30% đầu trang, không định nghĩa rõ chỉ số, không đóng khung phương pháp luận, thì một aggregator biết trình bày gọn gàng hơn hoàn toàn có thể lấy mất chính citation mà công sức nghiên cứu của bạn đáng lẽ phải có được. Thắng trong cuộc đua citation AI đòi hỏi cả hai vế cùng lúc: sở hữu con số không ai khác có, và cấu trúc nó theo đúng cách một cỗ máy bận rộn muốn đọc, chứ không phải theo cách một người đọc kiên nhẫn muốn được dẫn dắt từ từ đến cao trào ở cuối bài.
Nguồn dữ liệu:
1. https://api.on-page.ai/research/information-gain-study