


Theo dõi prompt vẫn đo lường được, miễn là bạn vận hành nó giống một cuộc thăm dò dư luận hơn là bảng xếp hạng từ khóa: chạy lặp nhiều lần, lấy mẫu theo quy tắc cố định và báo cáo kèm biên độ sai số, vì chạy cùng một prompt 3 lần trên ChatGPT thì chỉ còn khoảng 2,2% nguồn trích dẫn xuất hiện lại.
Tóm tắt các điểm chính
Câu trả lời của AI biến động mạnh, nhưng biến động không đồng nghĩa với không đo được.
Cách làm phổ biến (mỗi prompt chạy một lần, gộp mọi nền tảng thành một điểm) cho ra con số dễ khiến ban lãnh đạo hiểu sai.
Giải pháp của Infinity gồm 7 bước, từ thiết kế bộ prompt đến biến số liệu thành hành động riêng cho từng nền tảng.
Đích đến là một con số đủ vững để CMO bảo vệ khi phân bổ ngân sách.
Để hiểu ý tưởng của nội dung này, bạn có thể tham khảo thêm:
1/ Nội dung dựa trên triết lý thiết kế prompt bằng chân dung người dùng, được trình bày trong bài viết "Synthetic Personas: Nhân vật AI đại diện cho khách hàng để theo dõi prompt chính xác hơn" .
2/ Bạn đã đầu tư vào AI SEO (GEO/AEO) và cần một hệ thống đo lường thực sự theo dõi tiến độ của bạn so với nhiễu. Hãy xem bài viết "Các chỉ số đo lường AI Visibility" để tìm hiểu thêm.
1/ Câu trả lời AI mỗi lần một khác thì có nên bỏ qua việc theo dõi prompt?
Không nên. Biến động chỉ buộc ta đổi cách đo, từ xem một lần sang lấy mẫu nhiều lần, giống cách người ta dự báo thời tiết hay chấm điểm tín dụng.
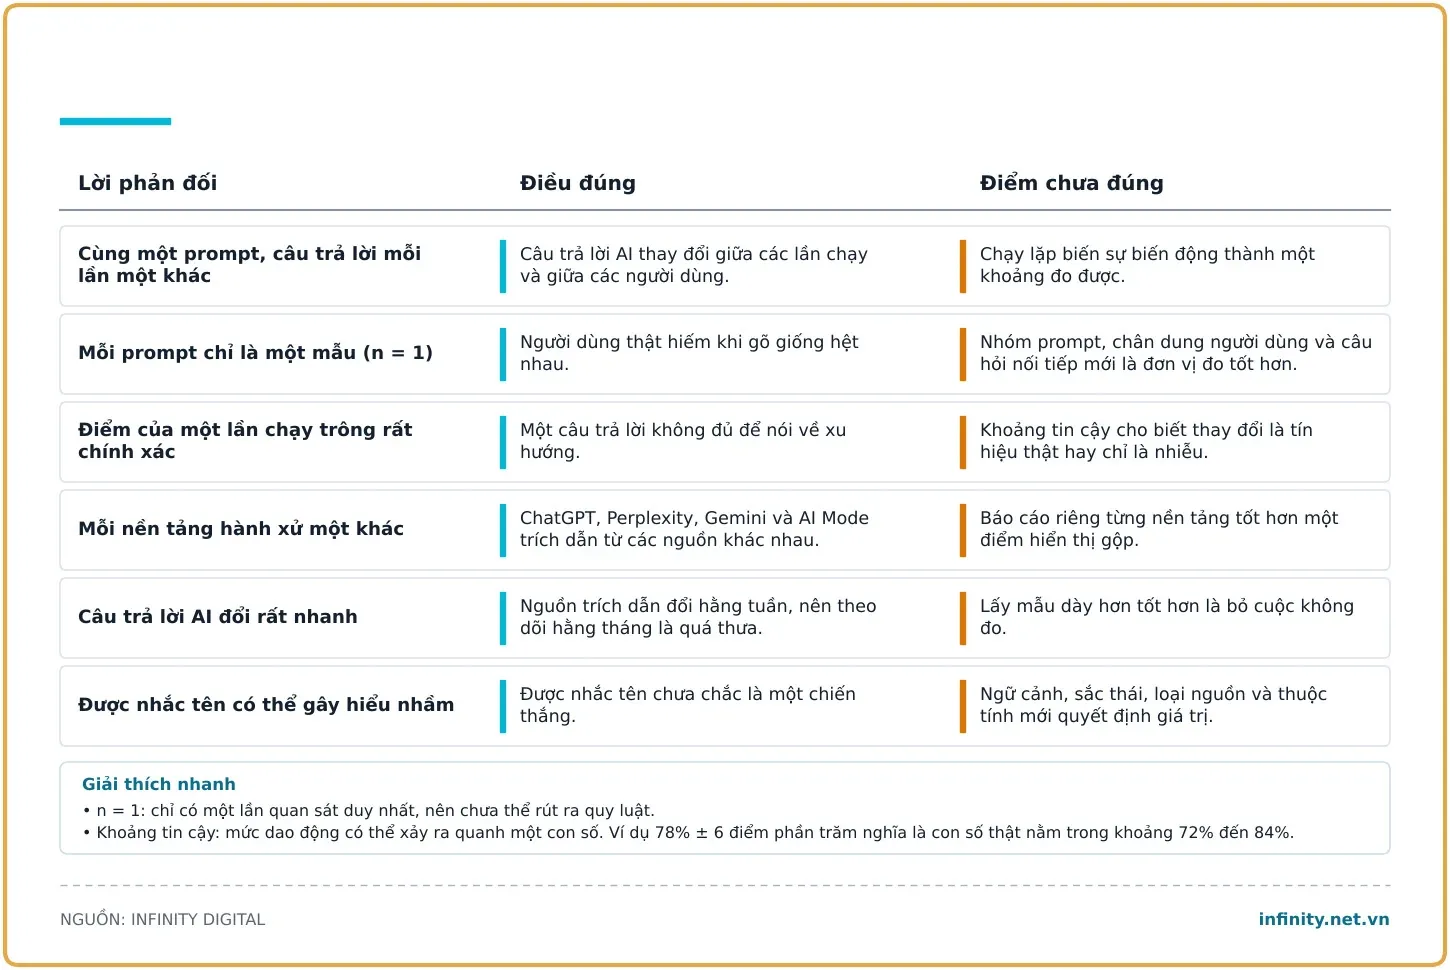
Những người phản đối prompt tracking nói đúng ở một điểm: 5 người chạy cùng một prompt sẽ nhận 5 câu trả lời khác nhau. Họ chỉ sai ở bước kết luận.
Riêng cơ chế lấy mẫu của mô hình đã khiến kết quả dao động từ 10% đến 34% trên những prompt giống hệt nhau.
Phân tích 815.000 cặp prompt và trang web cho thấy khi chạy lại cùng một prompt 3 lần trên ChatGPT, chỉ khoảng 2,2% nguồn trích dẫn còn lặp lại. Vì vậy, báo cáo kết quả của một lần chạy giống như huyền học vậy.
Còn một khó khăn nữa: prompt trung bình dài gấp khoảng 5 lần từ khóa tìm kiếm truyền thống, nên xác suất hai người trên thế giới gõ giống hệt nhau gần như bằng 0.
Mỗi prompt thực chất chỉ có một mẫu, và hiện ngành gần như không biết người dùng thật sự hỏi gì.
Bing và Google đang chia sẻ một phần dữ liệu hiển thị trên AI, nhưng chưa đủ để lấp khoảng trống đó.
Tuy vậy, việc theo dõi từ khóa trước đây cũng chưa bao giờ chuẩn như nhiều người nghĩ. Ví dụ:
Kết quả tìm kiếm theo địa phương đổi theo vị trí và thiết bị,
Google chấm lại thứ hạng mỗi ngày nên công cụ đo thứ hạng luôn báo một khoảng vị trí chứ không phải con số cố định.
Theo dõi từ khóa trước đây tập trung vào Google, nhưng giờ đây chúng ta có hàng tấn công cụ tìm kiếm.
2/ Vì sao doanh nghiệp không thể né việc đo lường hiển thị trên AI?
Vì Google đang chuyển từ tìm kiếm truyền thống sang tìm kiếm bằng AI, nên chỉ nhìn thứ hạng và lưu lượng là đang chấm điểm một cuộc chơi đang thu hẹp. Ngày càng nhiều lượt tìm kiếm hiển thị AI Overviews, và AI Overviews đang dần hợp nhất với AI Mode.
Tại Google I/O 2026, bà Liz Reid, người đứng đầu Google Search, cho biết người dùng ngày càng đặt những câu hỏi dài hơn, tự nhiên hơn. Ông Sundar Pichai mô tả Search là thứ “ít xoay quanh từng truy vấn riêng lẻ” và “giống một cuộc hội thoại liên tục” hơn. Khi đơn vị của hành vi tìm kiếm đã là cả cuộc hội thoại, cách đo cũng phải tính đến cả hành trình thay vì từng câu hỏi rời rạc.
Thêm một điểm đáng lưu ý: hiện có rất nhiều nền tảng AI, trong khi trước đây theo dõi từ khóa chủ yếu xoay quanh Google. Khi thị trường dần tập trung vào ít nền tảng hơn, việc đo lường sẽ đơn giản đi. Còn lúc này, mỗi nền tảng vẫn là một bài toán riêng.
3/ Vấn đề: cách theo dõi prompt phổ biến đang sai ở đâu?
Quy trình phổ biến hiện nay có ít nhất 7 lỗ hổng, và cùng nhau chúng khiến con số trên báo cáo thiếu độ tin cậy để làm căn cứ chi tiền.
Hai năm qua số công cụ tăng nhanh nhưng phương pháp phía sau gần như đứng yên. Quy trình quen thuộc là chọn 25 đến 50 prompt (chia theo thương hiệu, danh mục, vấn đề), chạy mỗi prompt một lần trên mỗi nền tảng, theo dõi hằng ngày, rồi chấm điểm theo việc có được trích dẫn, được nhắc tên, sắc thái và vị trí.
Bảy lỗ hổng cụ thể:
Chạy một lần nên phương sai quá lớn. Chỉ còn khoảng 2,3% nguồn trích dẫn sau 3 lần chạy, nên một lần chạy chẳng khác gì tung đồng xu mà không biết mặt nào ngửa. (Khoảng cách đồng thuận)
Bỏ qua mức độ suy luận của mô hình. Chế độ suy luận cao so với thấp chênh nhau 18 điểm phần trăm về tỷ lệ trích dẫn, và kích hoạt nhiều hơn 4,6 lần các truy vấn phụ mà AI tự sinh ra để tìm thông tin. Điểm tổng hợp đang trộn hai “bộ máy” khác nhau thành một con số sai lệch. (Khi AI ở chế độ suy luận sâu hơn)
Không tách theo chân dung người dùng. Phần lớn công cụ báo cáo câu trả lời chung chung, thứ mà không khách hàng thật nào thực sự làm vậy. (Chân dung khách hàng trong tìm kiếm AI)
Biến động chu kỳ. Khảo sát 82.619 prompt trong 17 tuần cho thấy AI Mode thay 56% nguồn trích dẫn mỗi tuần, còn ChatGPT thay tới 74%. Với tốc độ này, theo dõi hằng tháng giống việc một quý mới xem sao kê ngân hàng một lần.
Gộp nhiều nền tảng thành một điểm. Cộng ChatGPT, Perplexity và Gemini thành một điểm hiển thị cũng giống lấy trung bình thứ hạng Google và Bing.
Chỉ đo lượt hỏi đầu tiên. Lượt 1 cho biết thương hiệu có được nhắc hay không, nhưng không cho biết thương hiệu có trụ được từ lượt 2 trở đi, khi khách hỏi về phương án thay thế, giá, khả năng tích hợp hay rủi ro.
Đếm lượt nhắc mà không xét ngữ cảnh. Thương hiệu được nêu đầu tiên trong câu hỏi “phần mềm CRM tệ nhất nên tránh” vẫn bị ghi nhận là một chiến thắng.
Theo tôi, điểm đáng lo nhất không phải từng lỗ hổng riêng lẻ, mà là việc chúng cộng dồn: một con số trông rất chắc chắn trên bảng điều khiển nhưng thực chất không đủ cơ sở để quyết định ngân sách.
4/ Giải pháp của Infinity: một hệ thống theo dõi prompt của người dùng gồm 7 bước
Ta không thể loại bỏ biến động của câu trả lời AI, nhưng có thể chạy lặp prompt và đo xem phần nào của câu trả lời, lượt nhắc thương hiệu nào, nguồn trích dẫn nào còn ở lại qua nhiều lần chạy.
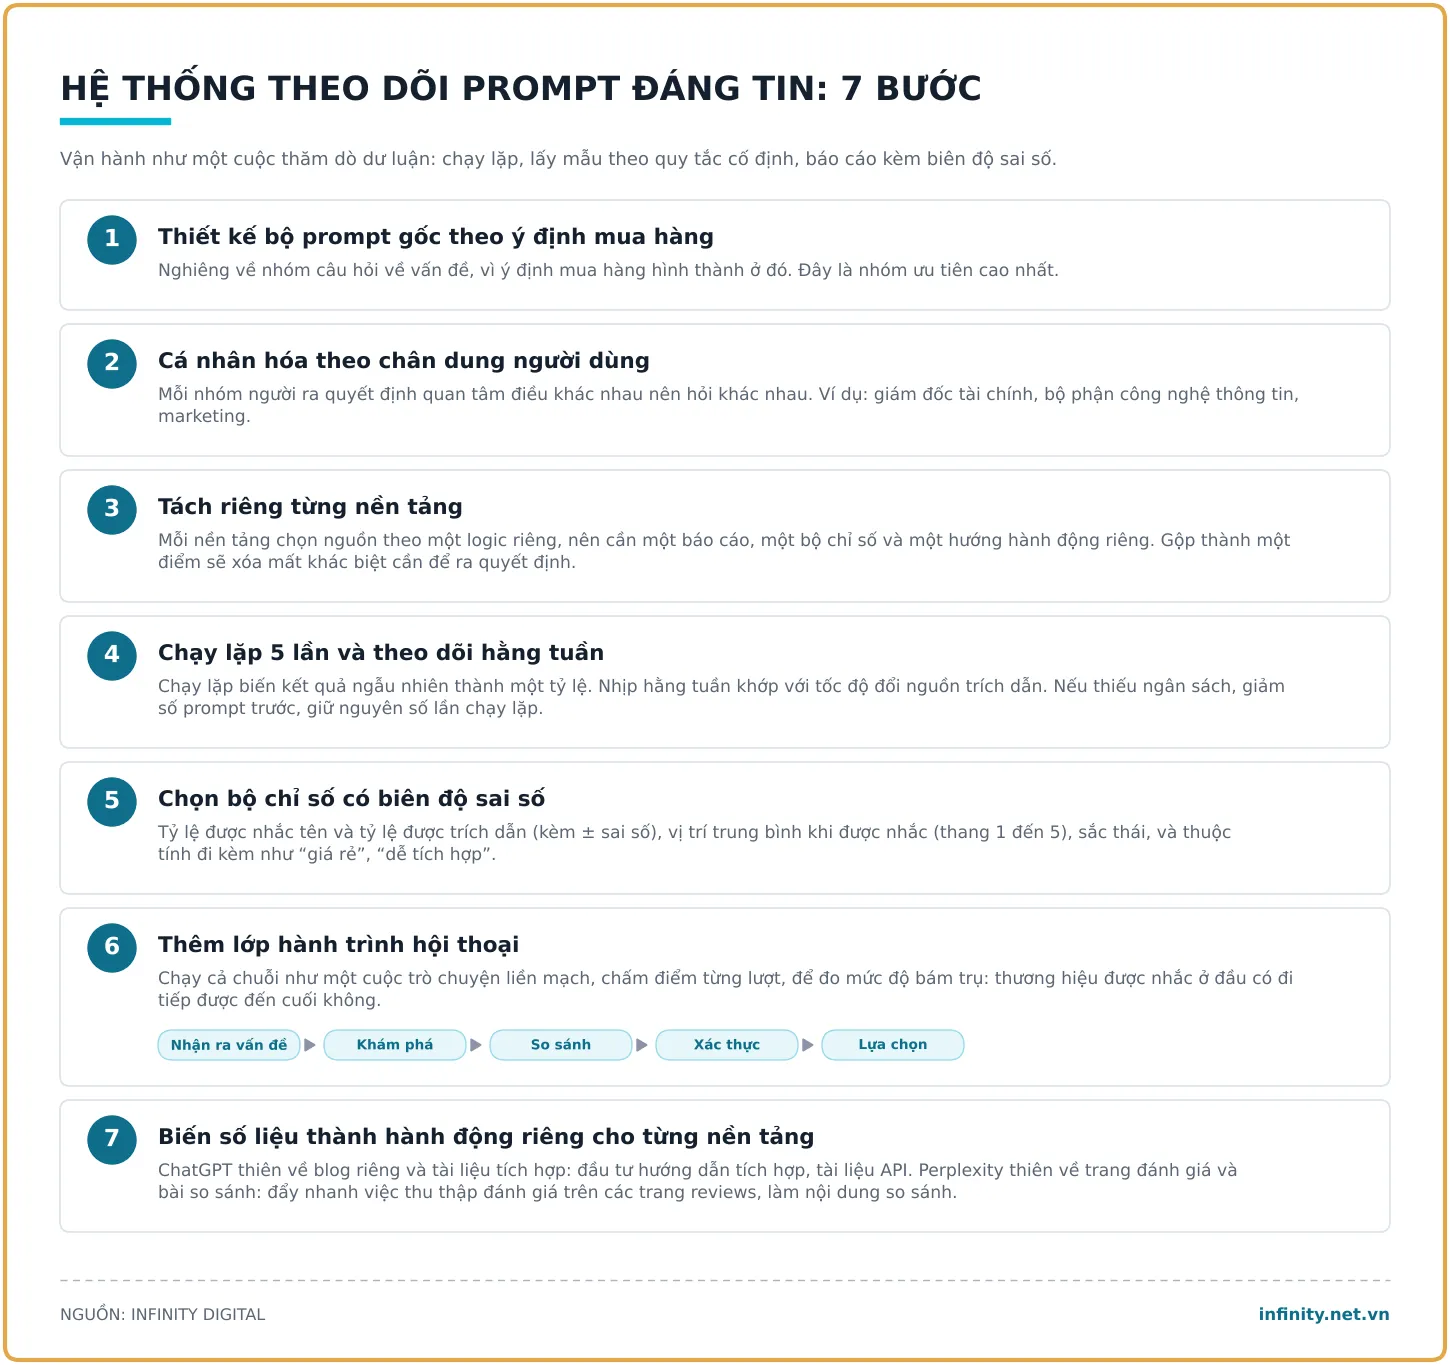
Bảy bước dưới đây được minh họa bằng một doanh nghiệp phần mềm B2B trong ngành CRM.
Bước 1: Thiết kế bộ prompt gốc theo ý định mua hàng
Bộ prompt gồm 40 câu, nghiêng về nhóm “vấn đề” vì ý định mua hàng hình thành ở đó:
12 câu hỏi về thương hiệu: kiểm tra AI nói gì khi khách đã biết tên bạn.
12 câu hỏi về danh mục: đo mức độ hiện diện khi khách đang tìm loại giải pháp.
16 câu hỏi về vấn đề: ưu tiên cao nhất, vì đây là lúc nhu cầu được định hình.
Bước 2: cá nhân hóa theo chân dung người dùng
Trong 40 prompt, 28 câu thuộc nhóm danh mục và vấn đề được viết lại cho 3 nhóm người ra quyết định:
Lấy 28 câu hỏi thuộc nhóm danh mục và vấn đề, viết lại cho 3 nhóm người ra quyết định: giám đốc tài chính, bộ phận công nghệ thông tin, bộ phận marketing.
Mỗi nhóm đặt câu hỏi theo mối quan tâm riêng, nên nhận câu trả lời khác nhau.
Bạn có thể thay bằng các nhóm phù hợp với tệp khách hàng của mình, miễn là mỗi nhóm có cách hỏi đủ khác biệt.
Bước 3: Tách riêng từng nền tảng
ChatGPT, Perplexity, Gemini và Google AI Overviews cần được theo dõi như bốn kênh độc lập, mỗi kênh một báo cáo, một bộ chỉ số và một hướng hành động, vì mỗi nền tảng chọn nguồn theo một logic riêng.
Không bao giờ gộp thành một điểm hiển thị duy nhất.
Mỗi nền tảng có một báo cáo, một bộ chỉ số và một hướng hành động riêng.
Khi thị trường tập trung lại, việc này sẽ đơn giản hơn, nhưng hiện tại vẫn cần tách.
Bước 4: Chạy lặp 5 lần và theo dõi hằng tuần
Mỗi prompt chạy 5 lần trên mỗi nền tảng, mỗi tuần một đợt. Chạy lặp biến một kết quả ngẫu nhiên thành một tỷ lệ, còn nhịp hằng tuần khớp với tốc độ thay đổi nguồn trích dẫn đã nêu ở phần trên.
Mỗi câu hỏi chạy 5 lần trên mỗi nền tảng, mỗi tuần một đợt.
Với 40 câu hỏi và 4 nền tảng, một đợt gồm 800 lượt chạy, đủ để tính tỷ lệ có biên độ sai số.
Nếu ngân sách hạn chế, Infinity khuyên giảm số prompt trước, giữ nguyên số lần chạy lặp, vì ít prompt nhưng chạy đủ lần vẫn đáng tin hơn nhiều prompt chạy một lần.
Bước 5: Chọn bộ chỉ số có biên độ sai số
Mỗi chỉ số cần đi kèm khoảng tin cậy để con số báo cáo là một khoảng có thể bảo vệ chứ không phải một điểm đơn lẻ. Bộ chỉ số gồm:
Tỷ lệ được nhắc tên, kèm biên độ sai số: thương hiệu xuất hiện trong bao nhiêu phần trăm lần chạy, cộng trừ bao nhiêu điểm phần trăm.
Tỷ lệ được trích dẫn, kèm biên độ sai số: website của bạn được dẫn nguồn trong bao nhiêu phần trăm lần chạy.
Vị trí trung bình khi được nhắc, theo thang 1 đến 5.
Sắc thái của câu trả lời: tích cực, trung lập hay tiêu cực.
Thuộc tính đi kèm mỗi lượt nhắc, chẳng hạn thương hiệu được gắn với “giá rẻ”, “dễ tích hợp” hay “khó dùng”.
Chỉ số cuối cùng hay bị bỏ qua nhất, nhưng nó trả lời câu hỏi quan trọng nhất: AI đang kể câu chuyện gì về thương hiệu của bạn.
Bước 6: Thêm lớp hành trình hội thoại
Một danh sách 40 prompt rời rạc chỉ đo được lượt hỏi đầu tiên. Vì AI là giao diện hội thoại, đơn vị đo nên là cả hành trình của người mua. Mỗi prompt gốc ở lượt 1 trở thành điểm xuất phát, và mỗi giai đoạn sau thêm một câu hỏi nối tiếp tự nhiên. Với người đang cân nhắc mua CRM, một hành trình đầy đủ đi qua 5 giai đoạn:
Nhận ra vấn đề: “Làm sao biết đội sales của tôi có cần CRM không?”
Khám phá: “Có những loại phần mềm CRM nào cho doanh nghiệp B2B SaaS?”
So sánh: “HubSpot, Salesforce và Pipedrive, cái nào hợp với đội sales 50 người?”
Xác thực: “HubSpot có đáng giá với doanh nghiệp B2B tầm trung không?”
Lựa chọn: “Bắt đầu dùng HubSpot Sales Hub như thế nào?”
Điểm mấu chốt là chạy cả chuỗi như một cuộc trò chuyện liền mạch thay vì 5 prompt tách rời, rồi chấm điểm từng lượt. Cách này cho phép đo “mức độ duy trì khả năng hiển thị thương hiệu trong AI”, tức thương hiệu được nhắc ở giai đoạn đầu có đi tiếp được đến giai đoạn cuối hay không. Trong dữ liệu tham chiếu, thương hiệu được trích dẫn ở giai đoạn nhận ra vấn đề bám trụ đến cuối trong 4 hành trình ở chế độ suy luận cao, và không hành trình nào ở chế độ suy luận tối thiểu. Công cụ chỉ chạy một lượt hỏi không bao giờ thấy được chỉ số này.
Hãy điều chỉnh phạm vi sao cho khối lượng công việc vẫn ở mức hợp lý. Theo dõi tất cả 40 gợi ý ban đầu ở Lượt 1 để nắm bắt phạm vi, và xây dựng 16 gợi ý vấn đề thành các hành trình 5 giai đoạn hoàn chỉnh để hiểu sâu hơn
Nếu không biết chính xác người dùng sẽ hỏi gì tiếp theo, có thể ước lượng các câu nối tiếp bằng AI, bổ sung bằng bản ghi hội thoại thật, và đưa vào theo dõi cả những câu gợi ý mà chính các mô hình đề xuất ở cuối câu trả lời.
Bước 7: Biến số liệu thành hành động riêng cho từng nền tảng
Giá trị của hệ thống nằm ở chỗ nó chỉ ra nên đầu tư vào đâu, và đây là bước CMO quan tâm nhất. Một phát hiện minh họa: HubSpot được nhắc trong 78% (cộng trừ 6 điểm phần trăm) số câu hỏi nhóm vấn đề trên ChatGPT, nhưng chỉ 34% (cộng trừ 9 điểm phần trăm) trên Perplexity. Lý do:
Perplexity ưu tiên các bài so sánh và trang đánh giá từ các bên thứ ba uy tín
Còn ChatGPT lấy nhiều từ blog riêng của HubSpot cùng tài liệu tích hợp và tuân thủ.
Từ đó ra hai hướng đầu tư khác nhau.
Muốn thắng trên ChatGPT, hãy đầu tư vào hướng dẫn, tích hợp, tài liệu.
Muốn thắng trên Perplexity, hãy đẩy nhanh tốc độ thu thập đánh giá trên trang reviews và xây nội dung so sánh.
Nếu gộp hai nền tảng thành một điểm, ta sẽ không bao giờ nhìn ra sự khác biệt này.
5/ Việc theo dõi prompt sẽ đi về đâu trong thời gian tới?
Nó sẽ không trở thành theo dõi từ khóa, mà sẽ giống một cuộc thăm dò dư luận hơn, vì câu trả lời AI quá biến động, quá cá nhân hóa và phụ thuộc nhiều vào cách chọn nguồn. Điều đó không có nghĩa là không đo được. Thế hệ công cụ tiếp theo sẽ có các đặc điểm của một cuộc thăm dò: chạy lặp, quy tắc lấy mẫu rõ ràng, khoảng tin cậy, chia nhóm theo chân dung người dùng và kiểm tra thủ công câu trả lời gốc. Trong lúc công cụ hiện có chưa bắt kịp, bạn hoàn toàn có thể tự dựng một phiên bản đơn giản theo 7 bước ở trên.
6/ Nên kiểm tra điều gì đầu tiên trong báo cáo hiển thị AI hiện tại?
Ba điều:
mỗi prompt đã được chạy lặp chưa,
mỗi nền tảng có được báo cáo riêng chưa,
và con số có kèm biên độ sai số hay không.
Nếu một trong ba câu trả lời là “chưa”, bảng báo cáo đang đưa ra con số trông chắc chắn nhưng thực chất là “xem bói”: chưa chạy lặp thì con số có thể đảo chiều chỉ sau một lần chạy lại, chưa tách nền tảng thì không biết nên đầu tư nội dung nào cho kênh nào, và chưa có biên độ sai số thì không thể phân biệt tăng trưởng thật với nhiễu. Khi đã chuyển sang cách đo kiểu thăm dò, bạn mới có số liệu đủ vững để quyết định đặt ngân sách vào tài liệu tích hợp, đánh giá của khách hàng hay nội dung so sánh.


