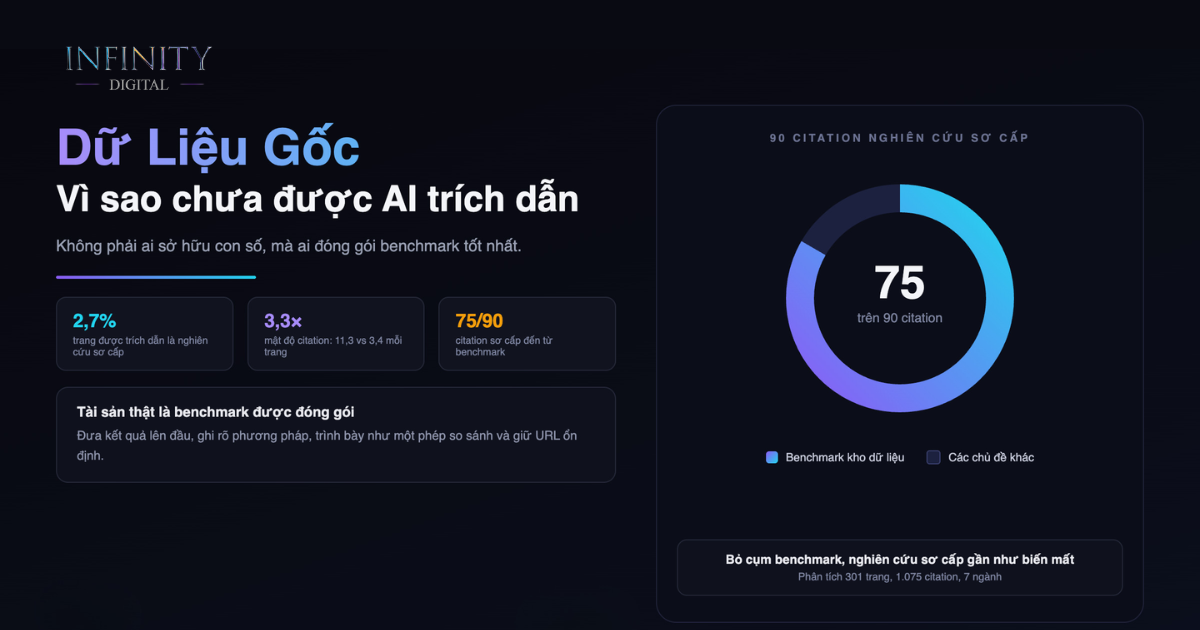

Sở hữu con số chỉ đưa bạn vào cuộc chơi. Điều giữ cho citation tiếp tục cộng dồn qua nhiều năm là việc đóng gói con số đó thành một phép so sánh có tên cụ thể, phương pháp minh bạch, cấu trúc dễ trích xuất, và một URL cố định.
Tóm tắt các điểm chính:
Từ dữ liệu citation mà Infinity phân tích, nghiên cứu first-party chỉ chiếm 2,7% số trang được trích dẫn nhưng có mật độ citation cao gấp 3,3 lần, và phần thắng gần như chỉ đến từ một định dạng: benchmark trả lời câu hỏi "cái nào tốt nhất".
Nghiên cứu first-party hiếm, nhưng khi có thì được trích dẫn dày hơn hẳn: 11,3 citation mỗi trang, so với 3,4 ở các trang còn lại.
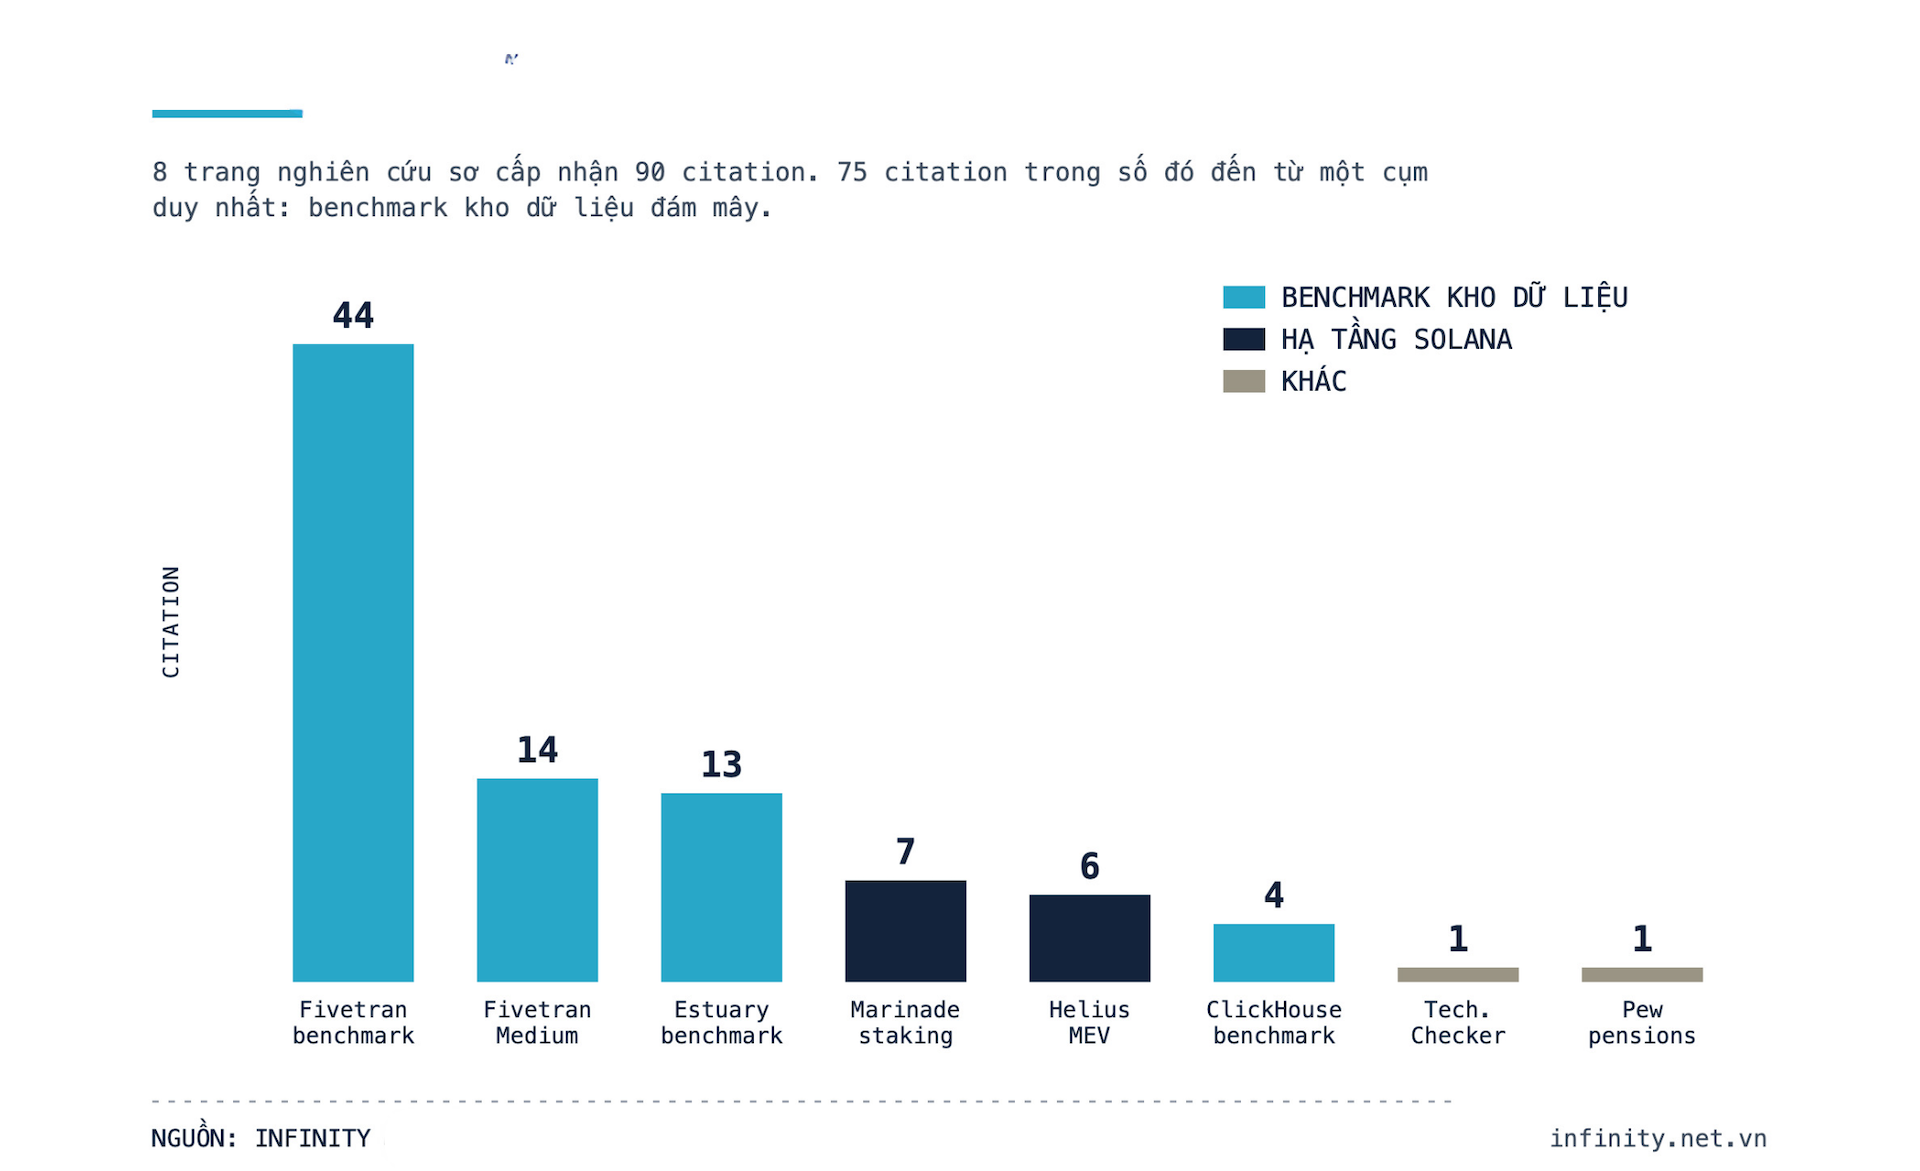
75 trên 90 citation của Primary research đến từ một cụm duy nhất: các benchmark so sánh sản phẩm theo thông số đo được.
Ở những chủ đề không có câu hỏi so sánh bằng số, không có trang Primary research nào được trích dẫn.
Tài sản thực sự không phải là sở hữu dữ liệu, mà là một benchmark được đóng gói để AI dễ truy xuất.
Đóng gói gồm bốn việc: đưa kết quả lên đầu, ghi rõ phương pháp, trình bày như một phép so sánh, và giữ URL ổn định.
Trong nội dung AI Visibility (Phần 7) được đăng tải thứ hai tuần này đã chỉ ra dữ liệu gốc là yếu tố dự đoán mạnh nhất cho tính nguyên bản của một trang, và ngưỡng để làm tốt hơn phần lớn thị trường khá thấp. Nội dung này đào sâu thêm vào các câu hỏi tiếp theo: khi đã có dữ liệu, AI thực sự trích dẫn thứ gì? Câu trả lời hẹp hơn nhiều so với khẩu hiệu "dữ liệu gốc là thắng", và cũng cụ thể hơn.
1/ Dữ liệu gốc hiếm đến mức nào, và hiệu quả ra sao?
Rất hiếm, nhưng khi xuất hiện thì được trích dẫn nhiều hơn hẳn các loại trang khác.
Phân tích 301 trang đang được AI trích dẫn (316 prompt trên 7 ngành, tổng cộng 1.075 citation). Sau khi kiểm tra từng URL, chỉ 8 trang đủ tiêu chuẩn là Primary research. 8 trang chiếm 2,7% số trang, nhưng giành 90 citation, tức 8,4% tổng citation.
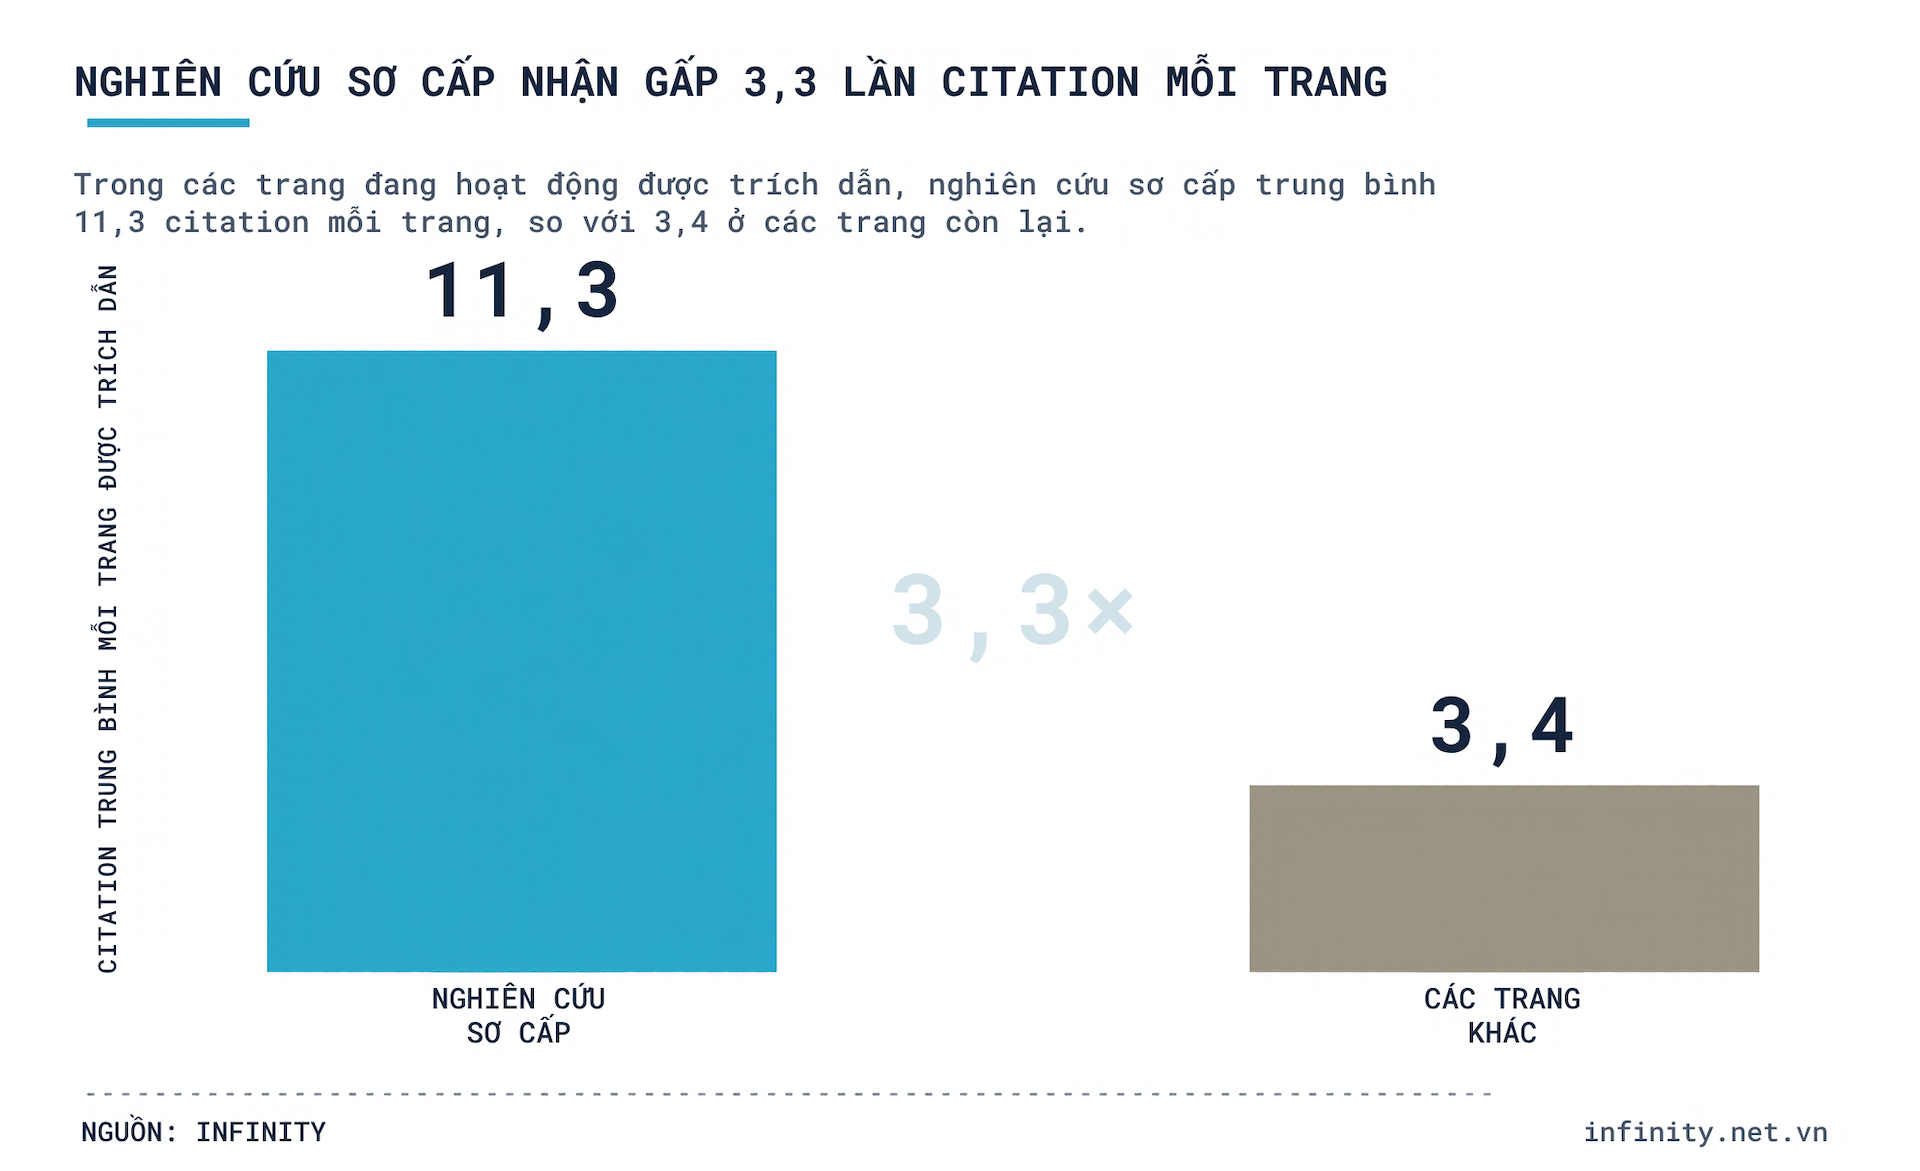
Trung bình một trang Primary research nhận 11,3 citation, các trang khác nhận 3,4.
Mật độ citation của Primary research cao gấp 3,3 lần.
Kết luận ở đây khớp với nội dung trước đó: con số mà chỉ bạn mới tạo ra được chính là đòn bẩy. Nhưng đừng vội kết luận rằng cứ xuất bản dữ liệu là đủ. Phân bố của 90 citation đó mới là phần đáng nói. Tiêu chuẩn ở đây là nguồn dữ liệu và phương pháp nằm ngay trên trang, không phải bài viết lại số liệu của người khác.
2/ Dữ liệu gốc thắng ở loại câu hỏi nào?
Chỉ ở những câu hỏi có thể trả lời bằng một benchmark.
Trong 90 citation của Primary research, 75 đến từ đúng một cụm chủ đề: so sánh hiệu năng các của các sản phẩm. Riêng một trang đã nhận 44 citation, và hai trang benchmark của cùng một công ty nhận 58. Bỏ cụm này ra, nghiên cứu first-party gần như không còn đáng kể trong tập dữ liệu.
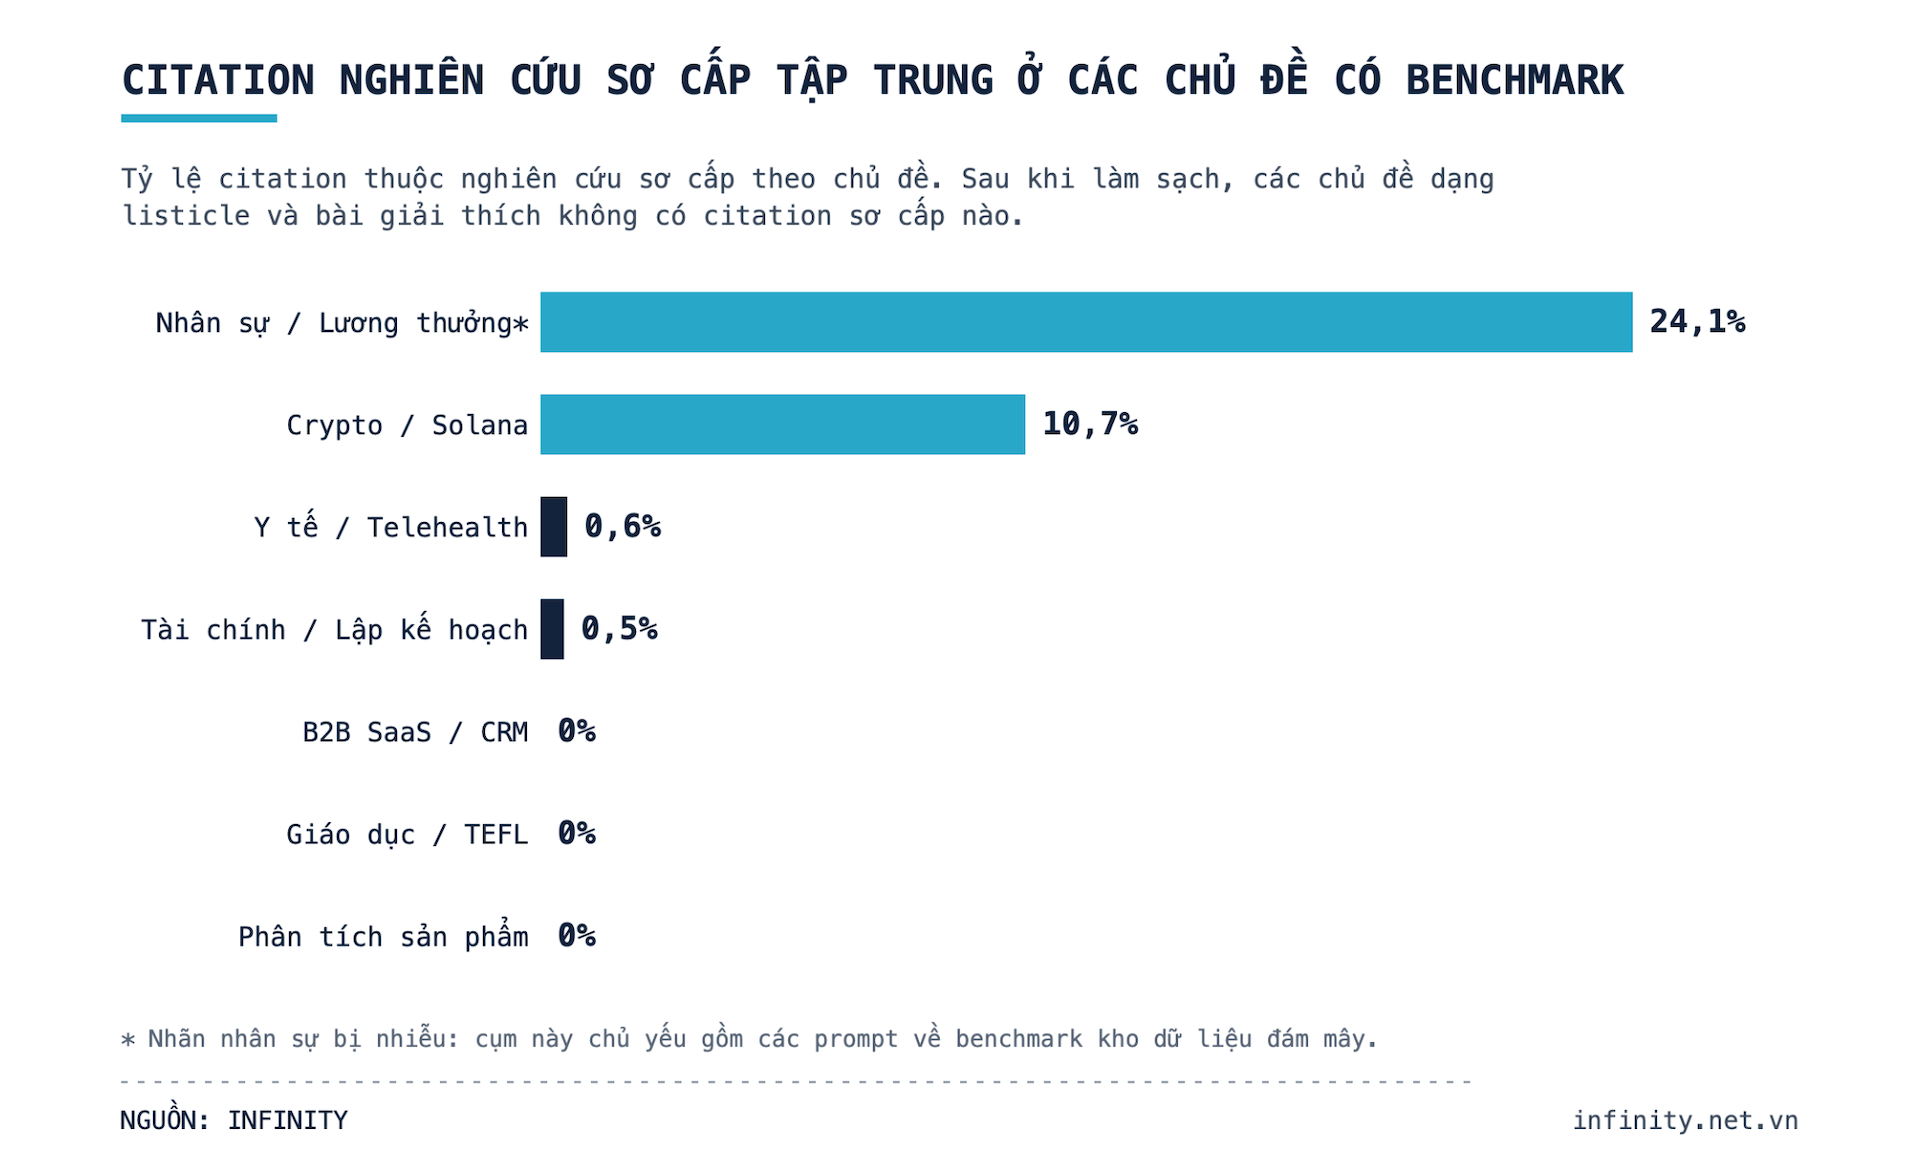
Mô hình biểu đồ trên biến mất ở những chủ đề không có benchmark rõ ràng. Với CRM, giáo dục hay phân tích sản phẩm, kết quả trả về toàn là listicle, trang sản phẩm, bài giải thích và case study. Sau khi làm sạch dữ liệu, không chủ đề nào trong số này có một trang Primary research được trích dẫn.
Logic ở đây khá đơn giản. AI cần nguồn có con số khi người dùng muốn so sánh bằng con số. Primary research sẽ hiệu quả nhất khi được trình bày theo cách trực tiếp trả lời các câu hỏi so sánh thương mại.
Vì vậy, việc đầu tiên là chọn đúng câu hỏi, rồi mới chọn dữ liệu. Đây cũng là điều Google gọi là nội dung phi hàng hóa (non-commodity content): thông tin mới, hữu ích, và khó tìm ở nơi khác.
Note định nghĩa: Benchmark ở đây nghĩa là đo một tập các đối tượng có tên cụ thể trên cùng một thước đo, rồi công bố kết quả bằng con số. Citation tập trung đúng ở nơi prompt yêu cầu AI so sánh các lựa chọn theo thông số đo được: tốc độ, chi phí, độ trễ, sản lượng hoặc hiệu năng.
3/ Điều gì khiến một trang benchmark nhận tới 44 citation?
Không phải bản thân con số, mà là toàn bộ công sức xung quanh con số.
Khi xem kỹ, có thể thấy bảy đặc điểm giải thích vì sao các mô hình ngôn ngữ ưu ái nó:
Trả lời thẳng một phép so sánh đo được: xếp hạng các sản phẩm có tên cụ thể theo tốc độ và chi phí, không ngại gọi tên mọi đối thủ lớn.
Chạy trên dữ liệu first-party thật: kiểm thử với mức sử dụng thực tế của khách hàng thay vì giả định tổng hợp, và nói rõ lựa chọn đó.
Trình bày phương pháp từng bước: dữ liệu nào được truy vấn, truy vấn nào được chạy, mỗi sản phẩm được cấu hình và tinh chỉnh ra sao. Người đọc, hay một mô hình AI, thấy được con số được tạo ra thế nào.
Cấu trúc sinh ra để được trích xuất: heading mô tả rõ như "Kết quả" hay "Vì sao kết quả của chúng tôi khác với các benchmark trước?" giúp AI ánh xạ một câu hỏi vào đúng đoạn trả lời nó.
Liên kết đến dữ liệu thô và nguồn tham khảo: mọi luận điểm đều kiểm chứng được. Rất ít thương hiệu làm đến mức công khai cả bộ dữ liệu.
Không giấu đường nối: có ghi chú đính chính kèm ngày tháng, nêu rõ giới hạn định tính, và cảnh báo trung thực về mức hiệu năng sàn. Những điều này làm các tuyên bố định lượng đáng tin hơn, không phải kém tin cậy đi.
URL chưa từng đổi: một trang từ năm 2022 vẫn nhận citation vì nó luôn nằm đúng một địa chỉ chuẩn.
Ý nghĩa rút ra: dữ liệu ngày nay dễ lấy và dễ phân tích hơn bao giờ hết. Cái khó là mọi thứ bao quanh nó, gồm phương pháp chuẩn, nguồn liên kết, đính chính minh bạch, cấu trúc dễ điều hướng, và sự trung thực với con số không chứng minh được điều gì. Đó là tay nghề, và đó mới là "hào" bảo vệ cho thương hiệu bạn. Một trang như vậy không phải thông cáo báo chí cẩu thả với dữ liệu lấy đại khái, nó tốn rất nhiều công sức và vẫn giữ được uy tín nhiều năm.
Từ đó có thể thấy cơ hội còn bỏ ngỏ: xuất bản một bộ dữ liệu có thể truy xuất cho một câu hỏi của người mua mà AI hiện chưa có nguồn benchmark chuẩn nào để dựa vào. Ở nhiều ngành, cánh cửa này đang mở và chưa ai bước qua với một bộ dữ liệu thật.
4/ Vì sao nhiều thương hiệu có dữ liệu mà vẫn mất citation?
Vì dữ liệu tồn tại nhưng không ở dạng AI có thể truy xuất, phân tích và ghép vào đúng câu hỏi.
Dữ liệu gốc cho một trang thứ mà bài giải thích nào cũng không có. Nhưng AI vẫn phải tìm thấy nó, đọc được nó, và nối nó với câu hỏi. Nhiều thương hiệu mất citation ở đúng khâu này:
để dữ liệu - con số trong lối kể chuyện dài dòng.
khóa dữ liệu sau một form đăng ký.
đổi URL mỗi lần làm lại website.
bỏ qua phần phương pháp luận.
Những trang thắng đều có cả hai thứ: con số gốc và một "cấu trúc nội dung dễ dàng để AI trích xuất”. Cụ thể, một trang nghiên cứu sẵn sàng được trích dẫn cần bốn phần:
Mở đầu bằng kết quả so sánh. Phát hiện chính (kiểu "X nhanh nhất, Y rẻ nhất ở quy mô lớn") nằm trong 30% đầu trang, theo thứ tự kết quả, rồi phương pháp, rồi sắc thái.
Đóng khung phương pháp luận. Cỡ mẫu, khung thời gian, đo cái gì, đo thế nào. Độ tin cậy về nguồn gốc là một phần của việc một con số đáng được trích dẫn.
Trình bày rõ như một phép so sánh nếu nó đúng là so sánh. AI tìm đến benchmark cho các prompt dạng "cái nào tốt nhất", và một bảng so sánh các lựa chọn có tên trên các thông số có tên là hình dạng nó dễ trích xuất nhất.
Giữ URL ổn định. Một trang chuẩn, luôn còn sống, không bị chuyển hay đổi tên theo mỗi đợt redesign. Citation giành được quý này chỉ cộng dồn nếu trang vẫn còn vào quý sau. Trong 365 URL được trích dẫn của tập dữ liệu, 64 URL đã chết, bị redirect hoặc hỏng, kéo theo 203 citation biến mất.
Bên thắng là những thương hiệu đang nắm dữ liệu sản phẩm, dữ liệu sử dụng hoặc dữ liệu giá độc quyền và đóng gói thành một phép so sánh mà người mua có thể hành động theo. Bên thua là những thương hiệu xuất bản số liệu gốc nhưng chôn trong lối kể chuyện, đặt trên trang chậm hoặc không ổn định, và không có khung so sánh nào để AI trích xuất.
5/ Phần khó nhất của một benchmark nằm ở đâu?
Không nằm ở dữ liệu, mà ở việc biến dữ liệu thành nội dung đáng trích dẫn, thể hiện được chuyên môn và vẫn còn giá trị sau nhiều năm cho các truy vấn thương mại.
Quy trình làm một benchmark có thể tóm lại trong bốn bước:
Liệt kê các điểm dữ liệu cần có.
Nhờ một người trong đội truy xuất bằng SQL.
Định nghĩa và ghi lại phương pháp để con số đứng vững trước sự soi xét.
Xây báo cáo xoay quanh một câu hỏi thật của khách hàng mục tiêu (ICP).
Và benchmark cần Phương pháp luận, phương pháp luận là quan trọng nhất, vì thiếu nó thì luôn có người tranh cãi dữ liệu của bạn. Với sự hỗ trợ của AI trong phân tích, phần dữ liệu giờ là phần dễ nhất. Phần việc thật sự nằm ở chỗ còn lại.
Kết luận
Với lãnh đạo marketing, khuyến nghị của Infinity là câu hỏi nên đặt ra không phải "mình có dữ liệu gì", mà là "câu hỏi so sánh nào của người mua mà AI chưa có nguồn số liệu sạch, và dữ liệu nào của mình trả lời được nó".